
译
本文是 OpenAI Spinning Up in Deep RL 教程第一部分 Part 1: Key Concepts in RL 的全文翻译,原仓库以 MIT 协议发布。原文的提示框、外链与代码示例全部保留,视频以链接代替嵌入。术语首次出现时附英文原词,之后沿用同一译名。
欢迎来到强化学习导论!这一部分的目标是让你熟悉:
- 讨论这一主题所用的语言与记号;
- RL 算法在做什么的高层解释(不过我们大多回避它们如何做到这一问题);
- 以及支撑这些算法的一点点核心数学。
概括地说,RL 研究的是智能体(agent)以及它们如何通过试错(trial and error)学习。它把这个想法形式化:对智能体的行为给予奖励或惩罚,会让它未来更倾向于重复或放弃该行为。
RL 能做什么
近年来,RL 方法收获了大范围的成功。例如,它被用来教计算机在模拟中控制机器人:模拟环境里,机器人被撞倒后重新站起来(视频);也在真实世界中这样做:真实机器人控制(YouTube)。
它还因在复杂策略游戏中造出突破性 AI 而闻名,最有名的是 Go(围棋)和 Dota;它教会计算机从原始像素玩 Atari 游戏,也训练过模拟机器人跟随人类指令。
关键概念与术语
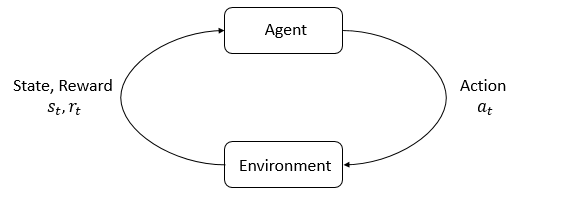
RL 的两个主角是智能体(agent)和环境(environment)。环境是智能体身处其中并与之交互的世界。交互的每一步,智能体都会看到世界状态的一个(可能不完整的)观测,然后决定要采取的动作。智能体作用于环境时,环境会随之改变,但它也可能自行变化。
智能体还会从环境感知到一个奖励(reward) 信号:一个数字,告诉它当前的世界状态有多好或多坏。智能体的目标是最大化自己的累积奖励,这个累积量称为回报(return)。强化学习方法,就是智能体学习行为以达成这一目标的各种途径。
要把 RL 做的事说得更具体,还需要引入一批术语。我们要讨论:
- 状态与观测;
- 动作空间;
- 策略;
- 轨迹;
- 回报的不同形式;
- RL 优化问题;
- 以及价值函数。
状态与观测
状态(state) 是对世界的完整描述,没有任何关于世界的信息被它遗漏。观测(observation) 则是对状态的部分描述,可能省略一些信息。
在深度 RL 中,我们几乎总是用实值向量、矩阵或更高阶张量来表示状态和观测。例如,一个视觉观测可以用其像素值的 RGB(红绿蓝)矩阵表示;机器人的状态可以用它的关节角度和速度表示。
当智能体能够观测到环境的完整状态时,我们说环境是完全可观测(fully observed) 的;当它只能看到部分观测时,我们说环境是部分可观测(partially observed) 的。
RL 的记号有时会在严格来说更适合写观测符号 的地方写状态符号 。描述智能体如何决定动作时就常见这种情况:记号上通常写作“动作以状态为条件”,但实践中动作取决于观测,因为智能体拿不到状态。
本指南遵循标准记号约定,具体指哪个应当能从上下文分辨出来。如果有不清楚的地方,欢迎到原仓库提 issue!我们的目标是把人教会,而不是把人绕晕。
动作空间
不同的环境允许不同种类的动作。一个给定环境中所有合法动作的集合,通常叫作动作空间(action space)。有些环境(比如 Atari 和围棋)具有离散动作空间(discrete action space):智能体可用的走法只有有限多个。另一些环境(比如智能体在物理世界中控制机器人)则具有连续动作空间(continuous action space):动作是实值向量。
这个区分对深度 RL 方法的影响相当深远:有些算法家族只能直接用于其中一种情形,要用到另一种情形上就得动大手术。
策略
策略(policy) 是智能体用来决定采取什么动作的规则。它可以是确定型(deterministic)的,通常记作 :
也可以是随机型(stochastic)的,通常记作 :
策略是智能体的大脑,所以拿「policy」一词替换「agent」来说话并不少见,比如『策略正在试图最大化奖励』。
在深度 RL 中,我们处理的是参数化策略(parameterized policy):这类策略的输出是可计算函数,函数依赖一组参数(比如神经网络的权重和偏置);通过某种优化算法调整这些参数,就能改变策略的行为。
这类策略的参数常记作 或 ,并写成策略符号的下标来点明这层关系:
确定型策略
例子:确定型策略。下面这段代码用 PyTorch 的 torch.nn 包,为连续动作空间构建一个简单的确定型策略:
pi_net = nn.Sequential(
              nn.Linear(obs_dim, 64),
              nn.Tanh(),
              nn.Linear(64, 64),
              nn.Tanh(),
              nn.Linear(64, act_dim)
            )
它构建了一个 MLP(multi-layer perceptron,多层感知机)网络:两个隐藏层各 64 个单元,激活函数是 。如果 obs 是装着一批观测的 Numpy 数组,可以这样用 pi_net 求出这批观测对应的动作:
obs_tensor = torch.as_tensor(obs, dtype=torch.float32)
actions = pi_net(obs_tensor)
神经网络的内容如果不熟悉,不必担心:本教程聚焦 RL,不展开神经网络那一侧。可以先跳过这个例子,之后再回来看。不过我们猜想,如果你已经了解,它会有所帮助。
随机型策略
深度 RL 中最常见的两种随机型策略是分类策略(categorical policy)和对角高斯策略(diagonal Gaussian policy)。
分类策略可用于离散动作空间,对角高斯策略则用于连续动作空间。
使用和训练随机型策略时,有两项关键计算居于中心地位:
- 从策略中采样动作;
- 计算特定动作的对数似然(log likelihood)。
接下来分别说明这两件事在分类策略和对角高斯策略上怎么做。
分类策略就像作用在离散动作上的分类器。构建分类策略的神经网络和构建分类器是同一套做法:输入观测,接若干层(视输入类型可以是卷积层或全连接层),最后一个线性层给出每个动作的 logits,再接一个 softmax 把 logits 转成概率。
采样。拿到每个动作的概率后,PyTorch 和 TensorFlow 这类框架都内置了采样工具,例如 PyTorch 的 Categorical 分布、torch.multinomial、tf.distributions.Categorical 或 tf.multinomial 的文档。
对数似然。记最后一层输出的概率为 。它是一个向量,条目数与动作数相同,因此可以把动作当作向量的索引。动作 的对数似然通过索引得到:
多元高斯分布(multivariate Gaussian distribution,也叫多元正态分布)由均值向量 和协方差矩阵 描述。对角高斯分布是协方差矩阵只有对角线元素的特例,因此可以用一个向量来表示它。
对角高斯策略总有一个从观测映射到均值动作 的神经网络。协方差矩阵通常有两种表示方式。
第一种:只有一个对数标准差向量 ,它不是状态的函数:这些 是独立的参数。(你应该知道:我们的 VPG(Vanilla Policy Gradient)、TRPO(Trust Region Policy Optimization)和 PPO 的实现用的就是这一种。)
第二种:有一个从状态映射到对数标准差 的神经网络,它可以选择性地与均值网络共享一些层。
注意,两种情况下输出的都是对数标准差,并非直接输出标准差。原因是对数标准差可以在 上自由取值,而标准差必须非负;不必强制这类约束,参数训练起来更容易。对对数标准差取指数即可立即得到标准差,所以这种表示不损失任何东西。
采样。给定均值动作 、标准差 ,以及一个来自球形高斯的噪声向量 (),动作样本可以这样计算:
其中 表示两个向量的逐元素乘积。主流框架都有内置的方式生成噪声向量,比如 torch.normal 或 tf.random_normal;也可以构建分布对象,比如 torch.distributions.Normal 或 tf.distributions.Normal,再用它们生成样本。(后一种方式的好处是,这些对象还能替你算对数似然。)
对数似然。对均值为 、标准差为 的对角高斯, 维动作 的对数似然为
轨迹
轨迹(trajectory) 是世界中状态与动作构成的序列:
世界的第一个状态 从初始状态分布(start-state distribution) 中随机采样,后者有时记作 :
状态转移(从时刻 的世界状态 到时刻 的状态 之间世界发生了什么)由环境的自然法则支配,且只依赖最近的动作 。它可以是确定型的:
也可以是随机型的:
动作则由智能体依照其策略产生。
轨迹也常被称为回合(episode) 或 rollout。
奖励与回报
奖励函数 在强化学习中至关重要。它依赖当前的世界状态、刚采取的动作和下一个世界状态:
不过它经常被简化成只依赖当前状态 ,或依赖状态-动作对 。
智能体的目标是最大化某种「沿轨迹累积的奖励」,但这话实际可以有几种含义。我们对所有这些情形统一记作 :具体指哪一种,要么能从上下文分辨,要么无关紧要(因为同样的方程适用于所有情形)。
一种回报是有限视界不折扣回报(finite-horizon undiscounted return):固定步数窗口内获得的奖励之和:
另一种是无限视界折扣回报(infinite-horizon discounted return):智能体曾经获得的全部奖励之和,但按奖励到来时刻的远近打折。这种回报形式引入了折扣因子 :
可我们为什么会想要折扣因子?难道不就是把所有奖励都拿到手吗?确实想,但折扣因子既直观又便于数学处理。直观层面:现在的现金好过以后的现金。数学层面:无限视界的奖励和可能不收敛到有限值,在方程里难以处理;而有了折扣因子,再加上合理条件,无穷和就收敛了。
这两种回报形式在 RL 形式化里界限分明,但深度 RL 的实践常把界线弄得相当模糊:比如我们经常把算法设定为优化不折扣的回报,却在估计价值函数时使用折扣因子。
RL 问题
无论选哪种回报度量(无限视界折扣,还是有限视界不折扣),也无论策略怎么选,RL 的目标都是:挑出一个策略,使智能体按它行动时的期望回报(expected return) 最大。
要谈期望回报,得先谈轨迹上的概率分布。
假设环境转移和策略都是随机型的。这时,一条 步轨迹的概率是:
期望回报(无论按哪种度量)记作 :
RL 的中心优化问题于是可以写成:
其中的 就是最优策略(optimal policy)。
价值函数
知道一个状态或状态-动作对的价值(value) 常常很有用。所谓价值,意思是:如果从该状态或状态-动作对出发,之后一直按某个特定策略行动,所能得到的期望回报。价值函数(value function) 以这样或那样的方式出现在几乎每一个 RL 算法里。
这里有四个值得注意的主要函数。
- 同策略价值函数(on-policy value function) :从状态 出发、之后一直按策略 行动,能得到的期望回报:
- 同策略动作价值函数(on-policy action-value function) :从状态 出发,先采取一个任意动作 (它可以不来自策略),之后一直按策略 行动,能得到的期望回报:
- 最优价值函数(optimal value function) :从状态 出发、之后一直按环境中最优的策略行动,能得到的期望回报:
- 最优动作价值函数(optimal action-value function) :从状态 出发,先采取一个任意动作 ,之后一直按环境中最优的策略行动,能得到的期望回报:
谈价值函数时,如果没有专门提到对时间的依赖,指的都是期望无限视界折扣回报。有限视界不折扣回报的价值函数必须把时间作为参数传入。你能想到为什么吗?提示:时间到了会发生什么?
价值函数与动作价值函数之间有两个经常用到的关键联系:
以及
这些关系可以直接从刚才给出的定义推出来:你能证明吗?
最优 Q 函数与最优动作
最优动作价值函数 与最优策略所选的动作之间有一个重要联系。按定义, 给出的是:从状态 出发、先采取(任意的)动作 、之后一直按最优策略行动时的期望回报。
状态 处的最优策略,会选择使「从 出发的期望回报」最大的那个动作。因此,如果我们手里有 ,就可以直接得到最优动作 :
注意:可能有多个动作同时使 最大,此时它们全都是最优的,最优策略可以随机选择其中任何一个。但总存在一个确定型地选择动作的最优策略。
贝尔曼方程
四个价值函数全都满足一类特殊的自洽方程,称为贝尔曼方程(Bellman equations)。贝尔曼方程背后的基本想法是:
你出发点的价值,等于你期望从待在那里得到的奖励,加上你下一落脚点的价值。
同策略价值函数的贝尔曼方程为:
其中 是 的简写,表示下一状态 从环境的转移规则中采样; 是 的简写; 是 的简写。
最优价值函数的贝尔曼方程为:
同策略价值函数与最优价值函数的贝尔曼方程之间,关键区别在对动作取不取 。 的存在反映了这样一个事实:每当智能体有机会自己挑动作,要想最优地行动,就必须挑那个带来最高价值的动作。
「贝尔曼备份(Bellman backup)」这个词在 RL 文献中出现得非常频繁。一个状态或状态-动作对的贝尔曼备份,就是贝尔曼方程的右边:奖励加下一状态的价值。
优势函数
有时在 RL 中,我们不需要绝对地描述一个动作有多好,只需要知道它平均而言比别的动作好多少。也就是说,我们想知道该动作的相对优势(advantage)。我们用优势函数(advantage function) 把这个概念精确化。
对应策略 的优势函数 描述的是:在状态 采取特定动作 ,比按 随机选一个动作好多少;这里假设之后一直按 行动。数学上,优势函数定义为:
这一点后面还会细讲:优势函数对策略梯度方法至关重要。
(选读)形式化
到目前为止,我们一直在非正式地讨论智能体所处的环境。但如果去翻文献,你很可能会遇到这个设定下的标准数学形式化:MDP(Markov Decision Process,马尔可夫决策过程)。一个 MDP 是五元组 ,其中:
- 是所有合法状态的集合;
- 是所有合法动作的集合;
- 是奖励函数,;
- 是转移概率函数(transition probability function), 表示从状态 出发采取动作 后转移到状态 的概率;
- 是初始状态分布。
「马尔可夫决策过程」这个名字来自系统服从马尔可夫性质(Markov property)这一事实:转移只依赖最近的状态和动作,不依赖更早的历史。